 RU

 IT
 23

Интерфейсы Google Search Console, Яндекс.Вебмастера, PageSpeed Insights и лимиты сервисов меняются, поэтому перед внедрением сверяйте чувствительные к дате данные в самих инструментах.
Задача SEO-аудита
SEO-аудит должен связать симптом с причиной и показать, что чинить первым. В нормальном результате есть URL или группа URL, данные из инструмента, объяснение проблемы и понятный порядок работ.
Диагностическая рамка результата
Начните с простой рамки. Ваш сайт состоит не из «страниц вообще», а из разных зон: главная, услуги, категории, карточки товаров, статьи, теги, фильтры, служебные страницы. Для каждой зоны вопрос будет свой. Категория интернет-магазина должна индексироваться, получать внутренние ссылки и отвечать на коммерческий запрос. Страница корзины, наоборот, не должна попадать в поиск. Если автоматический сервис ругается на обе одинаково, это не значит, что обе одинаково важны.
Google Search Console показывает данные о том, как Google видит сайт: URL Inspection дает сведения о сканировании, индексировании и показе страницы из индекса Google.
Для Яндекса нужна своя точка проверки. Яндекс.Вебмастер показывает техническое состояние сайта и данные из Яндекс Поиска, поэтому его нельзя заменять отчетом из Google. Бывает неприятная, но вполне рабочая ситуация: Google уже переобошел исправленную страницу, а Яндекс еще держит старый статус. Если для вашего бизнеса важен российский поиск, смотрите оба источника.
Яндекс.Вебмастер использует данные Яндекс Поиска и показывает техническое состояние сайта, поэтому его удобно брать как отдельный источник проверки для русскоязычного поиска.
Минимальная карточка проблемы выглядит так:
- Указан конкретный URL, шаблон или сегмент страниц.
- Зафиксирован симптом: нет индексации, упали показы, низкий CTR (click-through rate, доля кликов от показов), ошибка сервера, дубль.
- Назван источник данных: Google Search Console, Яндекс.Вебмастер, краулер, аналитика.
- Есть предполагаемая причина и понятно, как ее проверить.
- Понятен приоритет: что будет, если исправить сейчас, и что будет, если отложить.
Границы онлайн-аудита
Вопрос, который обычно возникает первым: можно ли ограничиться бесплатным анализом сайта онлайн? Можно, если задача - быстро проверить сайт на SEO-ошибки и понять, где копать. Нельзя, если по отчету уже нужно ставить задачи разработчику, редактору или владельцу каталога. Онлайн-аудит сайта видит признаки, но не знает вашу маржу, сезонность, ценность услуги и роль страницы в продажах.
Цена и глубина ручного аудита
Разница особенно заметна на деньгах. Открытые англоязычные ориентиры по услугам SEO-аудита дают широкий коридор: базовые аудиты от $300-800, комплексные часто $1 500-5 000, enterprise-аудиты могут уходить выше $10 000. На русскоязычном рынке базовые работы по SEO-продвижению лучше считать ориентиром, а не готовой ценой: стоимость зависит от размера сайта, региона, конкуренции и того, входит ли в работу только проверка или еще внедрение. Эти цифры не говорят, сколько должен стоить ваш проект. Они показывают другое: автоматическая проверка сайта онлайн и ручной комплексный SEO-аудит решают задачи разной глубины.
На рынке услуг SEO-аудита в 2026 году открытые англоязычные ориентиры дают широкий коридор: базовые аудиты от $300-800, комплексные часто $1 500-5 000, enterprise-аудиты могут уходить выше $10 000.
Очередность первого прохода
Первый проход удобно делать по такой очереди:
- Выберите страницы, которые влияют на трафик, заявки или продажи.
- Разделите их на сегменты: услуги, категории, карточки, статьи, фильтры, служебные URL.
- Проверьте, есть ли важные страницы в sitemap.xml и во внутренних ссылках.
- Сверьте индексацию в Google Search Console и Яндекс.Вебмастере.
- Отметьте проблемы, которые затрагивают сразу шаблон или много ценных URL.
- Отложите мелкие предупреждения на страницах, которые не должны продвигаться.
Четыре зоны проверки
Для ориентира держите перед глазами не общий балл, а четыре зоны проверки. Так меньше шансов потратить вечер на правку Description у страницы входа в личный кабинет и пропустить закрытую от индексации категорию, которая могла бы приносить заявки.
| Зона SEO-аудита | Основной вопрос проверки | Типовая единица анализа | Быстрый красный флаг |
|---|---|---|---|
| Сканирование и индексация | Могут ли поисковые роботы найти и проиндексировать нужные URL | URL, статус индексации, директива robots, sitemap-вхождение | Важная посадочная есть в sitemap, но исключена из индекса или закрыта от робота |
| Техническое качество | Не мешает ли реализация страницы загрузке, доступности и корректной обработке | Шаблон страницы, HTTP-статус, CWV-метрика, HTTPS, мобильная версия | Массовые 5xx, цепочки редиректов, плохие CWV на мобильных URL |
| Контент и интент | Соответствует ли посадочная страница запросу и ожиданию пользователя | Кластер запросов, Title, Description, H1, основной текст, canonical | Страница получает показы по запросам, но не отвечает на интент и имеет низкий CTR |
| Структура и внутренние ссылки | Получают ли важные страницы путь из навигации и внутренних ссылок | Уровень клика, внутренние ссылки, сиротский URL, хлебные крошки, меню | Коммерческая или трафиковая страница глубже 4 кликов либо найдена только через sitemap |
Не начинайте с попытки исправить все предупреждения подряд. У одинаковой ошибки разный вес: отсутствующий Description на служебном URL почти не важен, а закрытая категория с поисковым спросом может тормозить весь рост.
Сканирование и индексация: первый слой проверки
Проверка индексации показывает, дошел ли поисковик до ваших важных URL, выбрал ли их основными и может ли показывать в выдаче. Если слой ломается, правки текста и метатегов ждут.
Индексация сайта показывает, знает ли поисковик о ваших важных страницах и считает ли их пригодными для выдачи. Пока этот слой не подтвержден, правки текста, Title и внутренних ссылок остаются преждевременными.
В аудите есть неприятная ловушка: страница может существовать на сайте, открываться в браузере и даже лежать в sitemap.xml, но не быть нормальной поисковой страницей. Поисковик должен ее найти, скачать, понять, выбрать как основную версию и включить в индекс. Если цепочка рвется, вы можете месяцами улучшать текст, который робот почти не видит. Сначала проверьте доступность страницы для робота, а уже потом спорьте о тексте и сниппете.
Отчет Page indexing в Google Search Console показывает статус индексирования всех URL, которые Google знает в подтвержденном ресурсе.
В наших технических разборах мы часто начинаем с расхождения между тремя списками: что есть в CMS, что указано в sitemap.xml и что реально известно поиску. Page indexing report в Google Search Console показывает статус индексации всех URL, о которых Google знает в ресурсе; отчет можно фильтровать по всем известным страницам, страницам из sitemap и страницам вне sitemap. Если страницы вне sitemap активно попадают в обход, а важные посадочные остаются исключенными, проблема уже не в одном адресе. У сайта расходится фактическая структура и то, что вы хотите показать поиску.
SEO-аудит странная вещь: массовую ошибку видно быстро, а ее последствия проверяются медленно. Я сначала смотрю, какие группы URL робот не получает, не индексирует или получает через лишние переходы. Если ошибка бьет по страницам с трафиком или спросом, она идет первой. Если это один служебный адрес, он спокойно ждет. Дальше все зависит от масштаба: шаблонная проблема идет в работу сразу, точечная - после проверки влияния.
Статусы URL и исключенные страницы
Проверяйте статусы не по всему сайту сразу, а по выборке важных URL. Для маленького сайта это может быть главная, все услуги, несколько статей и страницы контактов. Для интернет-магазина - главные категории, подкатегории, карточки с продажами, бренды, фильтры с поисковым спросом. Вас интересуют не все исключенные адреса, а те, которые должны приносить органический трафик.
Здесь полезна диагностическая развилка. Когда важный URL исключен, сначала проверьте, почему это произошло: страница может повторять другую, быть слишком слабой, указывать поисковику на другой основной адрес, закрывать обход или просто быть служебной. Причина становится главной, когда страница есть в sitemap, получает внутренние ссылки, соответствует спросу и при этом остается в статусах вроде «обнаружено, не проиндексировано», «просканировано, не проиндексировано» или исключена как дубль.
Тревожные статусы стоит разбирать в таком порядке:
- Откройте важный URL в проверке страницы Google Search Console.
- Посмотрите, известен ли URL Google и может ли он быть проиндексирован.
- Сверьте статус в Яндекс.Вебмастере, если важен трафик из Яндекса.
- Проверьте, есть ли URL в sitemap.xml и во внутренних ссылках.
- Посмотрите, не выбран ли другой канонический адрес вместо нужного.
- Отметьте страницы со спросом, которые исключены как дубли или не проиндексированы.
Если страница со слабым фильтром товаров исключена из индекса, это может быть нормой. Если исключена страница услуги, на которую ведет меню и которая собирает спрос в вашем регионе, это уже причина для задачи. Такой подход экономит нервы: вы перестаете пугаться большого числа исключенных URL и начинаете смотреть, какие из них вообще должны работать в поиске.
robots.txt, sitemap.xml и ошибки сервера
robots.txt - файл с правилами обхода для поисковых роботов. Он говорит роботу, какие адреса можно запрашивать, но сам по себе не убирает страницу из поиска. Если на закрытый URL ведут ссылки, поисковик все равно может знать адрес и иногда показывать его без нормального содержимого. Для удаления страницы из индекса используют другие способы: noindex, корректный код ответа или закрытие доступа.
robots.txt сообщает поисковым роботам, какие URL они могут запрашивать; Google отдельно подчеркивает, что robots.txt не является способом убрать страницу из индекса Google - для этого нужен noindex или защита доступом.
sitemap.xml - карта сайта в техническом формате, где вы перечисляете важные страницы для поисковиков. Она помогает поиску быстрее находить URL, но не дает гарантии индексации. Один sitemap-файл для Google ограничен 50 000 URL или 50 МБ в несжатом виде; если каталог больше, карту разбивают на несколько файлов и используют общий индекс карт. На практике важнее другое: в sitemap не должны массово попадать закрытые, удаленные, неканонические и мусорные адреса. Иначе вы сами подаете поиску список страниц, которые не хотите продвигать.
Серверные ошибки смотрите до контента. Нужные страницы должны отдавать 200 OK, удаленные - 404, переехавшие - постоянный редирект без длинных цепочек. Массовые 5xx на шаблоне карточек или категорий имеют высокий приоритет: робот не может стабильно получить страницу. Мягкая 404 тоже вредная штука: сервер отвечает успехом, а по сути перед ним пустая страница, например фильтр без товаров или удаленная карточка с общим текстом.
В наших разборах robots.txt проверяется не только как текстовый файл. Google обычно кеширует содержимое robots.txt до 24 часов; при ошибках 5xx Google сначала останавливает краулинг сайта на 12 часов, затем до 30 дней может использовать последнюю корректную версию robots.txt, продолжая попытки получить новую. Поэтому смотрите код ответа файла, доступность, синтаксис и последствия для важных разделов. Один сбой сервера иногда выглядит как «почему-то поисковик перестал ходить по сайту».
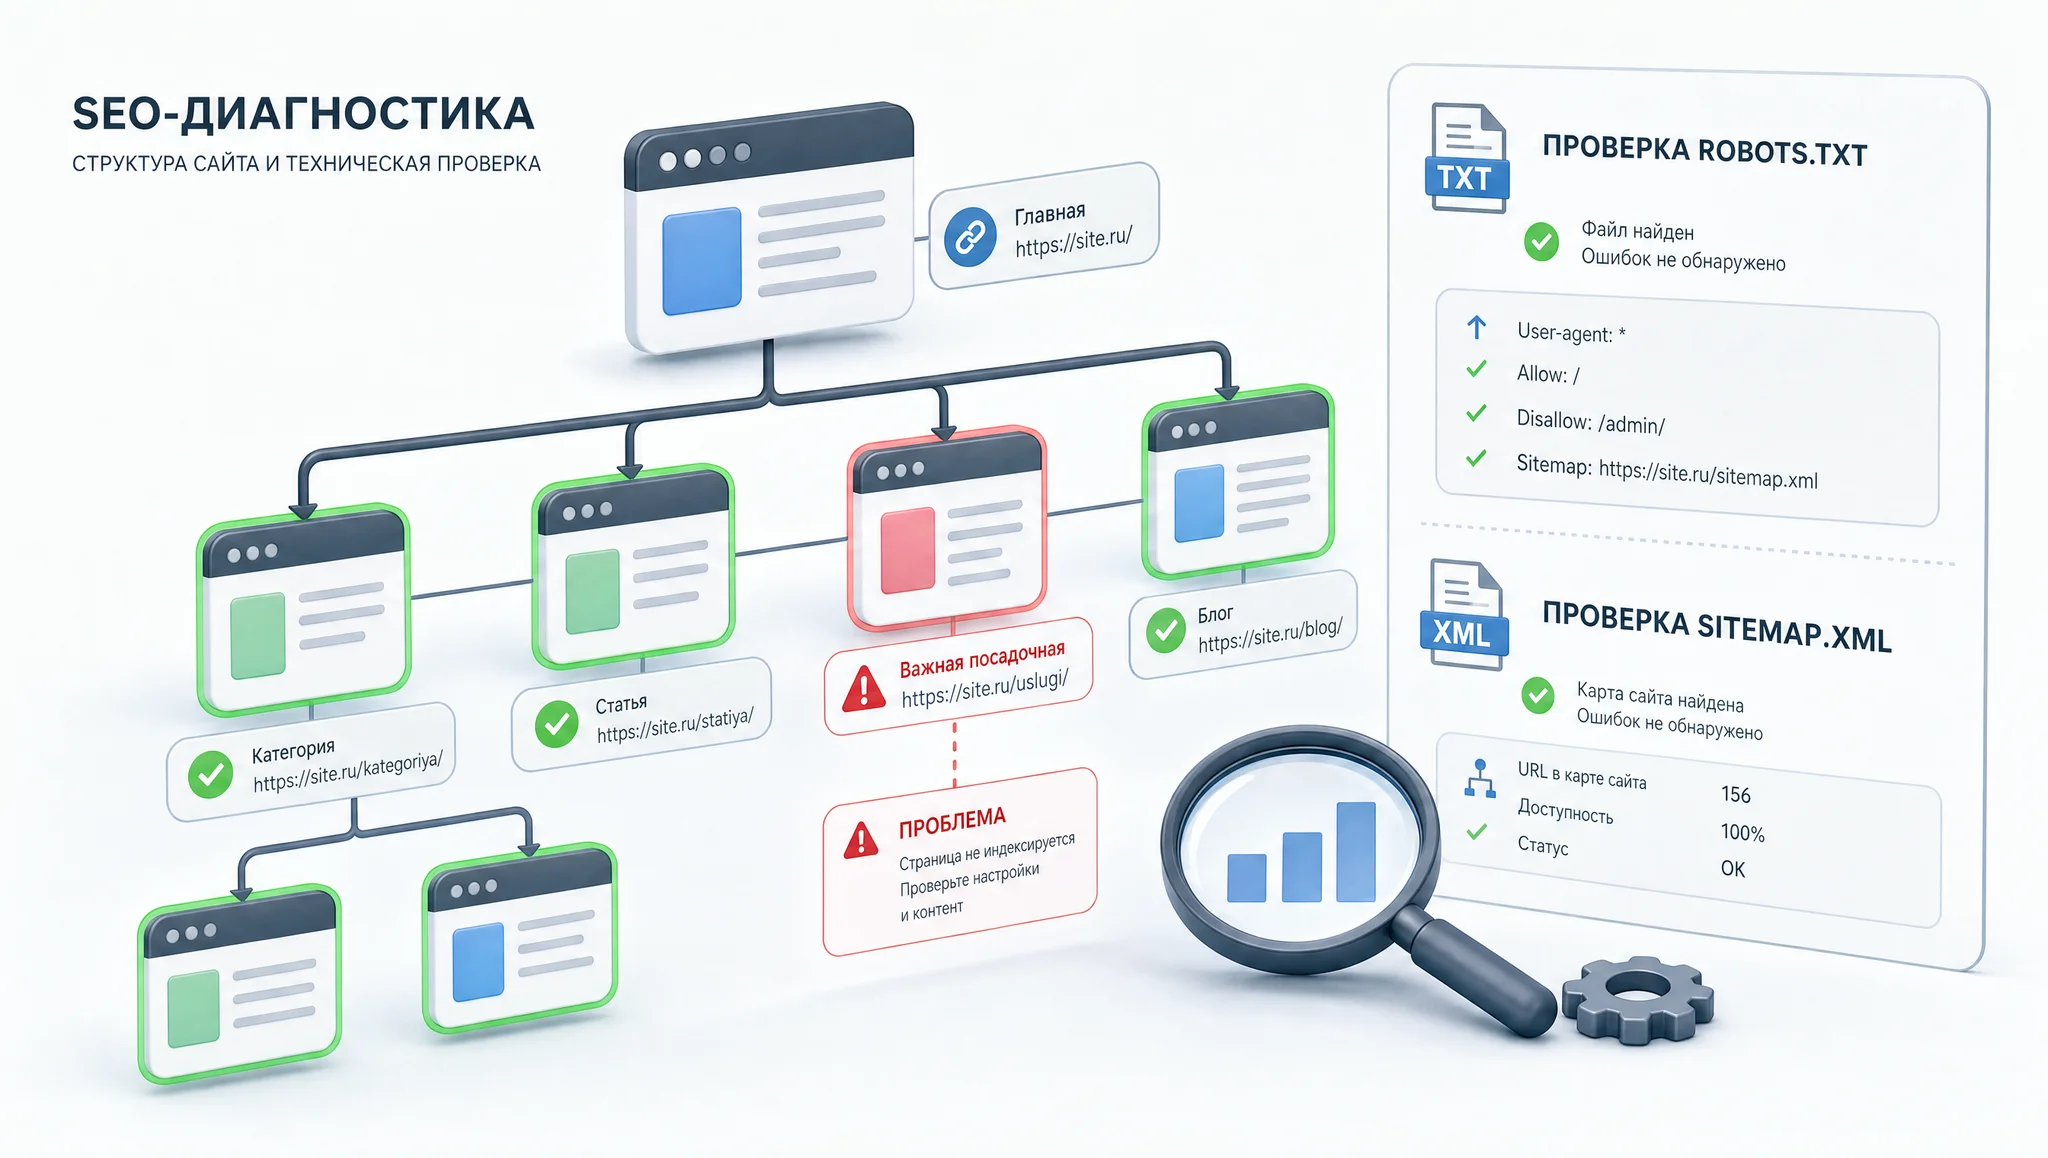
Для сайта на 30-50 страниц можно пройти индексацию вручную. Для каталога берите выборки по шаблонам: 20 категорий, 20 карточек, 20 фильтров, 20 статей. Иначе аудит превратится в случайное открывание вкладок.
Техническое качество без погони за идеальным баллом
Технический SEO-аудит проверяет, может ли робот и человек нормально получить страницу: сервер отвечает, мобильная версия работает, скорость не раздражает, а HTML не прячет важное содержимое.
Онлайн-аудит сайта удобен как первый фильтр. Сервис быстро покажет редиректы, 404, пустые Title, отсутствие Description, проблемы с HTTPS и часть ошибок разметки. Но техническая диагностика начинается по-настоящему там, где вы смотрите не цвет индикатора, а масштаб. Одна 404 на старой акции - мелочь. Тысячи битых ссылок из меню, карточек или статей - уже проблема структуры.
Screaming Frog SEO Spider - desktop-краулер для аудита сайта; официальный лимит бесплатной версии - до 500 URL за одно сканирование, платная лицензия снимает лимит и добавляет расширенные функции.
Screaming Frog полезен тем, что показывает сайт как набор связанных URL: статусы ответа, редиректы, Title, Description, H1, canonical, глубину, внутренние ссылки и дубли. Если у вас до 500 URL, бесплатной версии часто хватает для первого полного обхода. Если страниц больше, не пытайтесь обмануть лимит хаотичной выборкой. Разбейте сайт на сегменты и сканируйте их отдельно: категории, карточки, статьи, теги, пагинацию, фильтры. Так вы увидите шаблонные ошибки, а не случайные пять страниц, которым просто не повезло попасть в отчет.
Коды ответа, редиректы и HTTPS
Начните с того, что реально мешает получить страницу. Коды 5xx говорят о проблемах сервера. Коды 4xx показывают недоступные адреса. Редиректы сами по себе нормальны, если страница переехала, но цепочки из нескольких переходов замедляют обход и путают диагностику. HTTPS тоже входит в базовую проверку: Google начал использовать HTTPS как сигнал ранжирования в августе 2014 года; на старте это был легкий сигнал, затрагивавший менее 1% глобальных запросов. Вывод простой: HTTPS нужен как норма качества и безопасности, но сам по себе не заменяет нормальную страницу.
Симптом «много технических ошибок» разбирайте по причинам. Сервер может падать только на одном шаблоне, старые URL могут вести в цепочки редиректов, а часть 404 может быть нормальным следом удаленных страниц. Главной причина становится тогда, когда ошибка повторяется на ценной группе URL: карточках, категориях, услугах, статьях с показами. Одна старая акция с 404 спокойно ждет.
В технической проверке высокий приоритет получают:
- 5xx - ошибки сервера на важных шаблонах страниц;
- 4xx - битые внутренние ссылки, по которым ходит робот и пользователь;
- цепочки редиректов - лишние переходы при открытии важной страницы;
- ошибки HTTPS - смешанный контент, просроченный сертификат, доступность HTTP-версии;
- мобильные поломки - элементы, которые нельзя открыть или нажать на телефоне.
Скорость, мобильность и Core Web Vitals
Core Web Vitals показывают, когда появляется главный контент, реагирует ли страница на действие и насколько сильно элементы прыгают во время загрузки. Для хорошего значения ориентиры такие: LCP не более 2,5 секунды, INP не более 200 мс, CLS не более 0,1. Для читателя это проще: страница должна быстро показать главное, не тормозить после нажатия и не сдвигать кнопку под пальцем.
Пороговые значения Core Web Vitals для хорошего пользовательского опыта: LCP не более 2,5 секунды, INP не более 200 мс, CLS не более 0,1.
PageSpeed Insights сообщает о пользовательском опыте страницы на mobile и desktop и дает рекомендации по улучшению страницы. Это бесплатный сервис Google для проверки скорости и удобства страницы. В нашей практике это хороший бесплатный тест сайта по отдельным URL, но не вся техническая картина. Проверять нужно шаблоны: главная, категория, карточка, статья, форма заявки. Если одна статья получила плохой балл из-за огромной картинки, это локальная задача. Если все карточки медленно показывают фото и цену, это уже шаблонная проблема.
Проверяйте скорость последовательно:
- Выберите по одному важному URL каждого типа страницы.
- Проверьте mobile и desktop в PageSpeed Insights.
- Отдельно выпишите LCP, INP и CLS.
- Сравните результаты у основных шаблонов сайта.
- После исправлений дождитесь накопления реальных данных, если сайт небольшой.
Один лабораторный прогон не доказывает победу. Полевые данные меняются после накопления визитов, поэтому маленькие сайты иногда ждут обновления дольше. Если вы вчера сжали изображения и сегодня увидели старые полевые значения, это не обязательно провал. Сразу проверяются серверные ответы и размер ресурсов, а эффект в реальных метриках смотрят позже.
Мобильную версию проверяйте руками, а не только по баллу. Iloveadaptive помогает быстро посмотреть, как страница выглядит на разных экранах, но решает не сервис, а простая проверка: виден ли главный текст, можно ли нажать кнопку, не уезжает ли форма, читается ли меню. Если на телефоне нельзя выбрать товар или отправить заявку, технический балл уже не утешает.
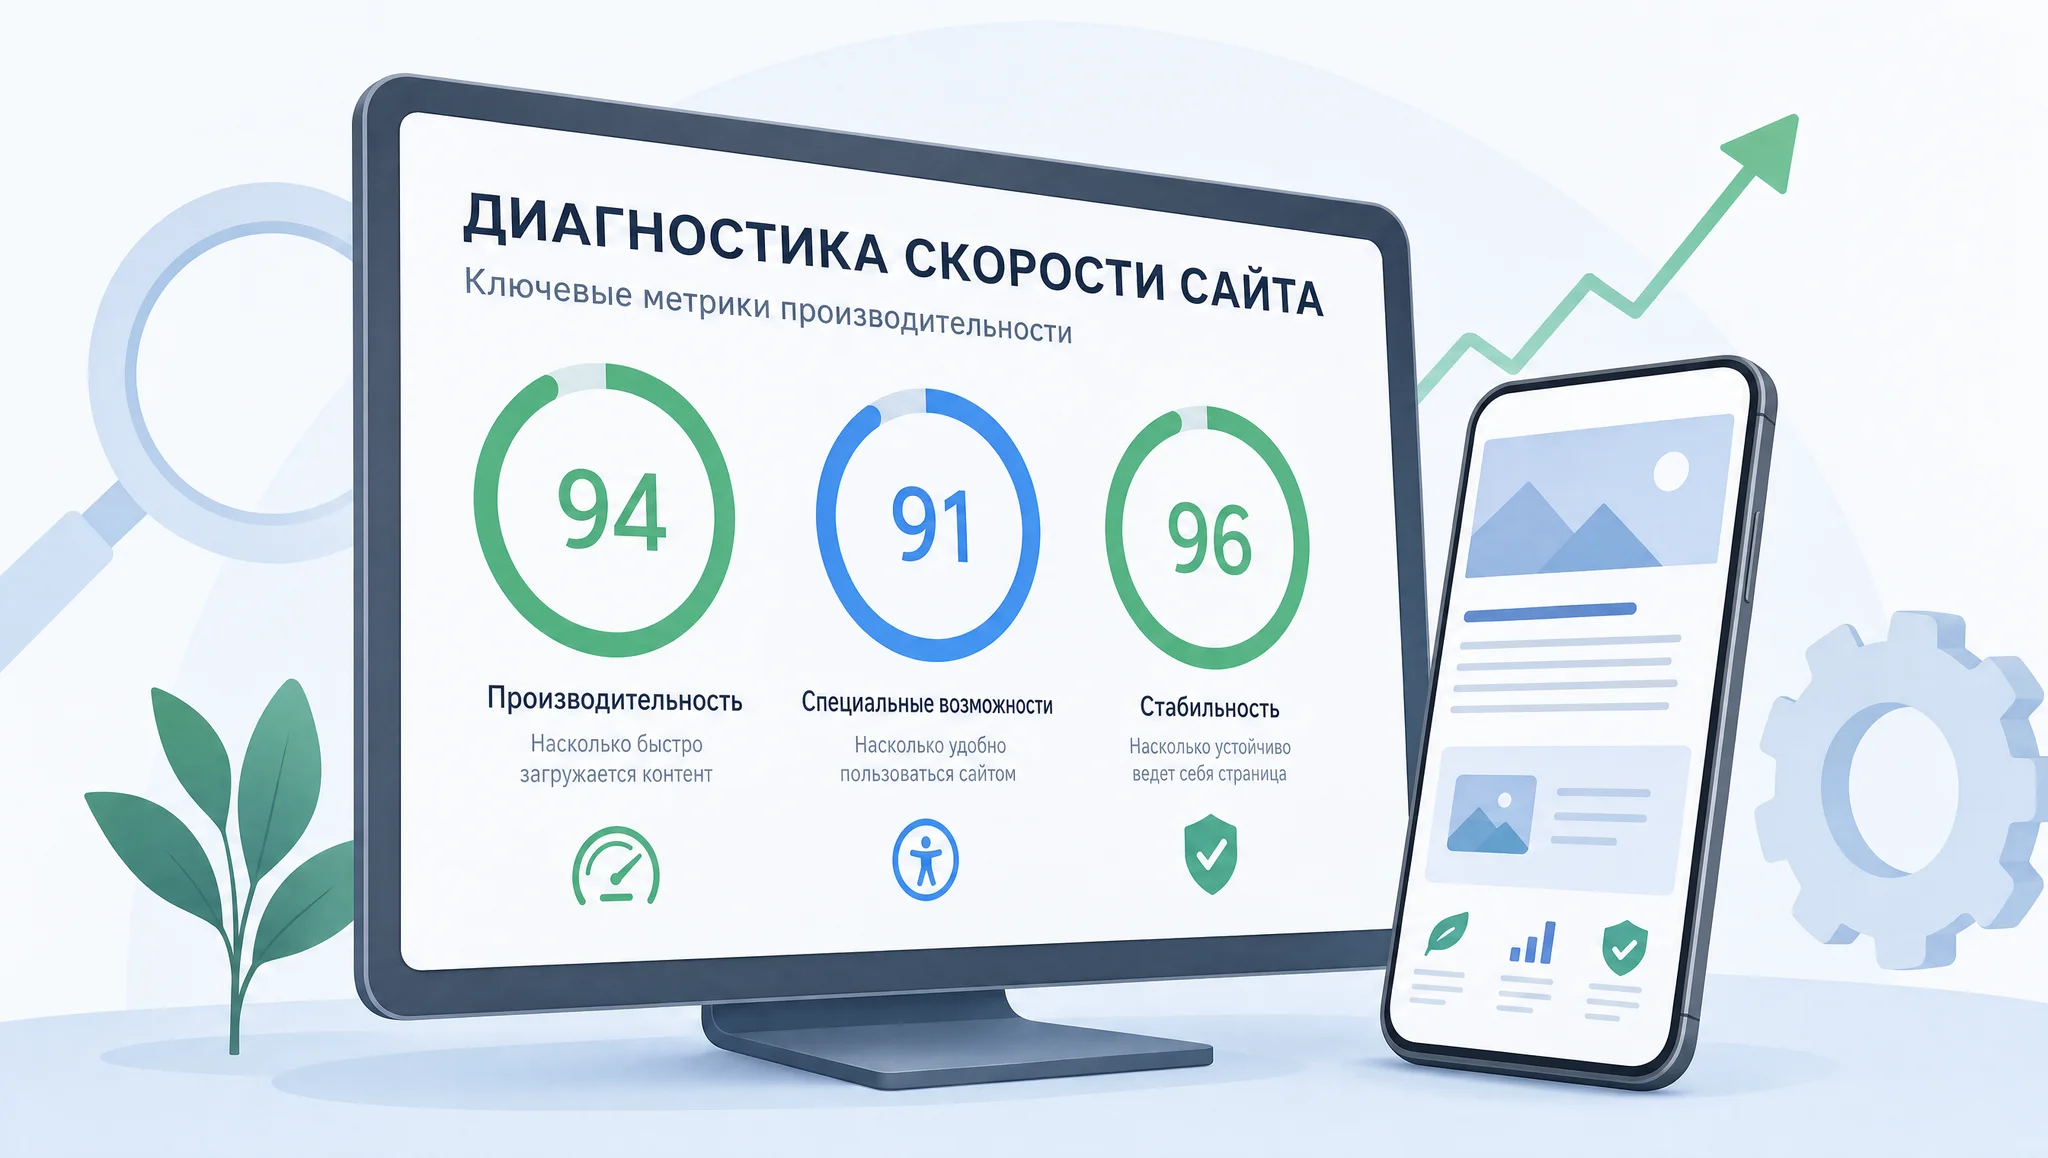
Не чините скорость ради красивого числа в отчете. Чините конкретный шаблон, где медленная загрузка мешает пользователю увидеть товар, форму, цену, текст инструкции или другой главный элемент страницы.
Контент и соответствие запросам
Контентная проверка начинается там, где URL уже индексируется и получает показы, но ответ на странице не совпадает с намерением человека. Значит, проблему нужно сверять с запросами.
Интент - это намерение человека за поисковым запросом. Он хочет купить, сравнить, узнать определение, найти инструкцию, скачать документ, выбрать город или открыть конкретный бренд. Если страница услуги пытается одновременно продать, объяснить термин, ответить на десятки вопросов и показать новости компании, она часто не закрывает нормально ни один сценарий. Для самостоятельного SEO-анализа сайта достаточно грубой проверки: один важный URL должен отвечать на один основной кластер запросов.
Google использует разные источники для формирования title link в выдаче, но владельцы сайта могут влиять на него через понятные и релевантные title; после изменений Google должен заново просканировать и обработать страницу, что может занять от нескольких дней до нескольких недель.
Title, Description и H1 проверяются не как магические поля, а как обещание страницы. Title помогает поиску и человеку понять тему результата. Description может попасть в сниппет, если поисковик сочтет его точным описанием страницы, но гарантированной длины у него нет: текст может обрезаться под устройство и запрос. Поэтому не надо играть в «идеальные 160 символов» любой ценой. Лучше коротко и честно сказать, что человек найдет на странице.
Посадочная страница и поисковые запросы
Откройте отчет Performance в Google Search Console и посмотрите запросы по конкретной странице. Там есть четыре базовые метрики: клики, показы, CTR и средняя позиция; CTR считается как клики, деленные на показы. Для вас это способ понять, как страницу видит поиск. Если URL получает показы по информационным запросам, а ведет на сухой коммерческий шаблон без ответа, CTR будет слабым, а поведение на сайте - нервным: человек пришел спросить «как выбрать», а страница сразу показывает форму до ответа на информационный запрос.
Сигналы несоответствия запросу:
- страница получает показы по вопросам, но на ней нет понятного ответа;
- коммерческий URL ранжируется по информационным запросам и плохо собирает клики;
- Title обещает одно, а H1 и текст раскрывают другое;
- страница конкурирует с другой страницей вашего же сайта по тем же запросам;
- форма, цена или условия спрятаны там, где человек их не ждет.
Что вы сами ожидали бы увидеть по этому запросу: ответ сразу, каталог, таблицу цен, инструкцию, сравнение вариантов или карточку товара? Это не игра в вкус. Ответ показывает, какую причину проверять первой: слабое обещание в Title, не тот тип страницы, внутреннюю конкуренцию или отсутствие нужного ответа.
Дубли, canonical и уникальность текста
Canonical - это подсказка поисковику, какой URL считать основной версией среди похожих страниц. Она нужна для похожих версий одной страницы: товара, статьи или категории. Такие версии часто появляются из-за параметров, сортировок, слешей, UTM-меток или разного регистра. Canonicalization - выбор представительного URL из набора дублей; Google использует канонический URL, чтобы показывать в результатах поиска одну версию похожего или дублирующегося контента.
Canonicalization - это выбор представительного URL из набора дублей; Google использует канонический URL, чтобы показывать в результатах поиска одну версию похожего или дублирующегося контента.
Разные дубли дают разные последствия. Дубликат Title часто показывает шаблонную или плохо разделенную семантику. Дубликат Description чаще влияет на сниппет и CTR. Дубликат основного текста может привести к тому, что поисковик выберет другую каноническую версию. Проверка уникальности через Text.ru, Etxt.ru, Advego или Copyscape полезна как фильтр копипаста, но не заменяет проверку смысла. Уникальный текст может быть бесполезным, если он не отвечает на запросы, по которым страница реально получает показы.
Отдельно проверьте то, что часто остается «на потом»: ALT у важных изображений, Open Graph для нормального вида ссылки в соцсетях, Schema.org для структурированных данных и hreflang, если у сайта есть языковые версии. Это не первые кнопки, на которые жмут при аварии, но после индексации и интента они помогают поиску и людям аккуратнее понять страницу.
Контентную проверку удобно пройти так:
- Выберите URL с показами, но слабым CTR или слабой конверсией.
- Выгрузите запросы этой страницы из Google Search Console.
- Разделите запросы на коммерческие, информационные и брендовые.
- Сравните Title, H1 и первый экран с главным типом запросов.
- Проверьте, нет ли второй страницы сайта с тем же назначением.
- Запишите, что нужно изменить: ответ, структуру, цену, таблицу, форму, примеры.
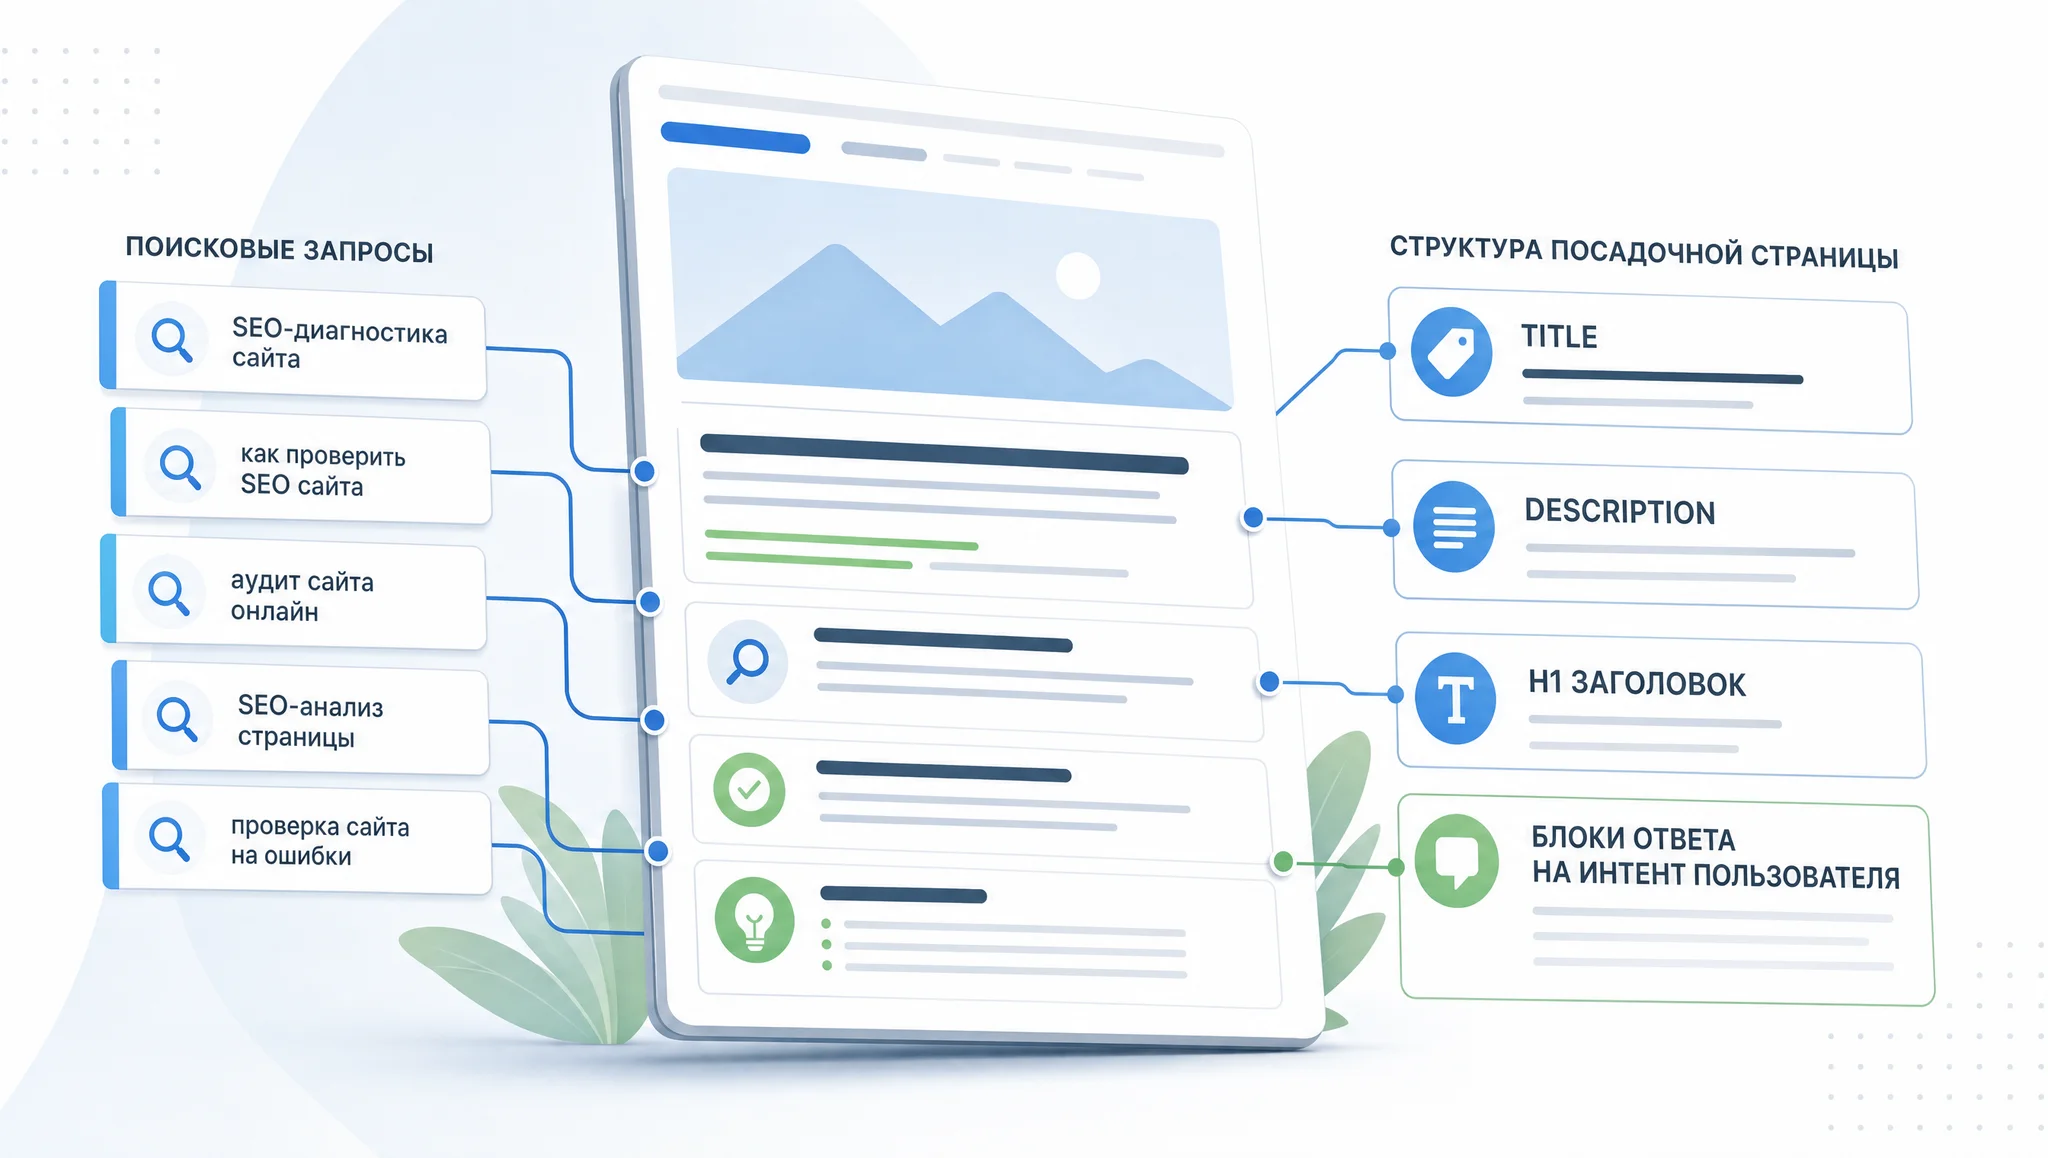
Если страница получает показы, но не получает клики, не спешите переписывать весь текст. Сначала проверьте обещание в Title, сниппет, соответствие запросу и конкурирующие страницы внутри вашего сайта.
Структура и внутренние ссылки
Структура сайта показывает поисковику, какие страницы важны и как они связаны между собой. Важный URL должен иметь путь из навигации или контента, а не просто числиться в sitemap.
Поисковые системы находят новые страницы по ссылкам. Внутренняя навигация помогает человеку дойти до нужного раздела, а роботу - найти и связать страницы между собой. В рекомендациях Google по ссылкам важны доступные для обхода ссылки и понятный текст ссылки. Проще: важная страница должна иметь нормальный путь из меню, раздела, хлебных крошек, списка товаров, статей или других страниц. Если адрес живет одиноко в карте сайта, он слабее передает свою роль.
Google использует ссылки для поиска новых страниц и как сигнал релевантности; рекомендации Google по ссылкам включают crawlable-ссылки и понятный anchor text.
Сиротская страница - это URL без внутренних ссылок с других страниц сайта. Она может быть в sitemap и даже попасть в индекс, но поисковику труднее понять ее место в архитектуре. Особенно плохо это работает для новых статей, карточек товаров, региональных посадочных и страниц услуг. Человек тоже редко найдет такую страницу сам, если не пришел из поиска или рекламы.
Глубина, меню и страницы без пути
Глубина показывает, за сколько кликов от главной страницы можно добраться до URL. Жесткого универсального числа нет, но коммерческая или трафиковая страница глубже 4 кликов - повод посмотреть внимательнее. Иногда это нормально для огромного каталога. Иногда это значит, что важную услугу спрятали так, будто компания сама в нее не верит.
Симптом слабой структуры обычно выглядит так: страница есть, спрос есть, а пути почти нет. Возможные причины разные: URL выпал из меню, рубрика не ссылается на новые статьи, фильтр создает адреса без нормальных ссылок, карточки лежат глубже, чем нужно. Главной становится та причина, которая повторяется на группе важных страниц и мешает роботу пройти к ним обычным путем.
Проверьте внутренние ссылки в такой последовательности:
- Выгрузите важные URL из sitemap.xml, CMS или вашей таблицы посадочных.
- Запустите краулер и посмотрите, какие из них находятся через внутренние ссылки.
- Отдельно отметьте URL, найденные только в sitemap.
- Проверьте глубину клика для услуг, категорий, статей и карточек.
- Откройте HTML важных ссылок и убедитесь, что там есть обычный href.
- Добавьте ссылки из меню, рубрик, хлебных крошек или тематических страниц там, где путь слабый.
Навигационная ссылка в JS-элементе, форме, фильтре или кнопке без обычного href может быть неудобной для сканирования. Поэтому спорные элементы проверяют краулером и вручную в HTML, особенно на мобильной версии. Если робот не видит атрибут href у важной ссылки, он может не связать страницу с нормальной структурой сайта и слабее понять ее роль.
ЧПУ, параметры и понятные адреса
ЧПУ - человекопонятный URL, адрес страницы, который можно прочитать без набора странных параметров. В аудите проверяют не красоту адреса, а стабильность и однозначность. Один товар, категория или текст не должны открываться по нескольким индексируемым адресам с разными параметрами, слешами, регистрами или UTM-метками. Иначе поисковик тратит обход на дубли и выбирает основную версию сам.
В структуре чаще всего ломаются такие места:
- фильтры каталога - создают много похожих адресов без спроса и товаров;
- пагинация - прячет карточки глубоко и плодит слабые страницы;
- теги - дублируют рубрики или собирают случайные подборки;
- региональные страницы - отличаются только названием города и выглядят как копии;
- старые акции - остаются в ссылках, хотя уже не несут пользы.
Внешний ссылочный профиль
Ссылочный профиль проверяют по внешним ссылкам, которые ведут на ваш сайт. Для самостоятельного аудита достаточно отметить общий признак: есть ли у важных страниц естественные упоминания, не ведут ли на сайт массовые странные доноры, не просели ли ссылки после переезда или смены структуры. Глубокий разбор уже делают в Ahrefs, Semrush, Serpstat или MegaIndex: там смотрят доноров, анкоры, потерянные ссылки, конкурентов и страницы, на которые чаще всего ссылаются.
Не превращайте этот слой в охоту за каждым подозрительным доменом. Для первого диагноза важнее другое: если сайт технически открыт, страницы отвечают на запросы, но видимость заметно слабее конкурентов, ссылочный профиль становится одной из рабочих гипотез. Для проверки видимости рядом могут пригодиться Топвизор, SimilarWeb, Keys.so, XTOOL и Яндекс ИКС: они не заменяют друг друга, зато помогают увидеть, где просадка похожа на проблему спроса, конкурентов или доверия к сайту.
Если главная, меню, рубрики и внутренние ссылки ведут к одним страницам, а sitemap - к другим, поисковик получает смешанный сигнал. Исправление тут часто простое по смыслу и неприятное по внедрению: убрать лишние пути, усилить важные URL и перестать создавать новые дубли при каждом фильтре или сортировке.
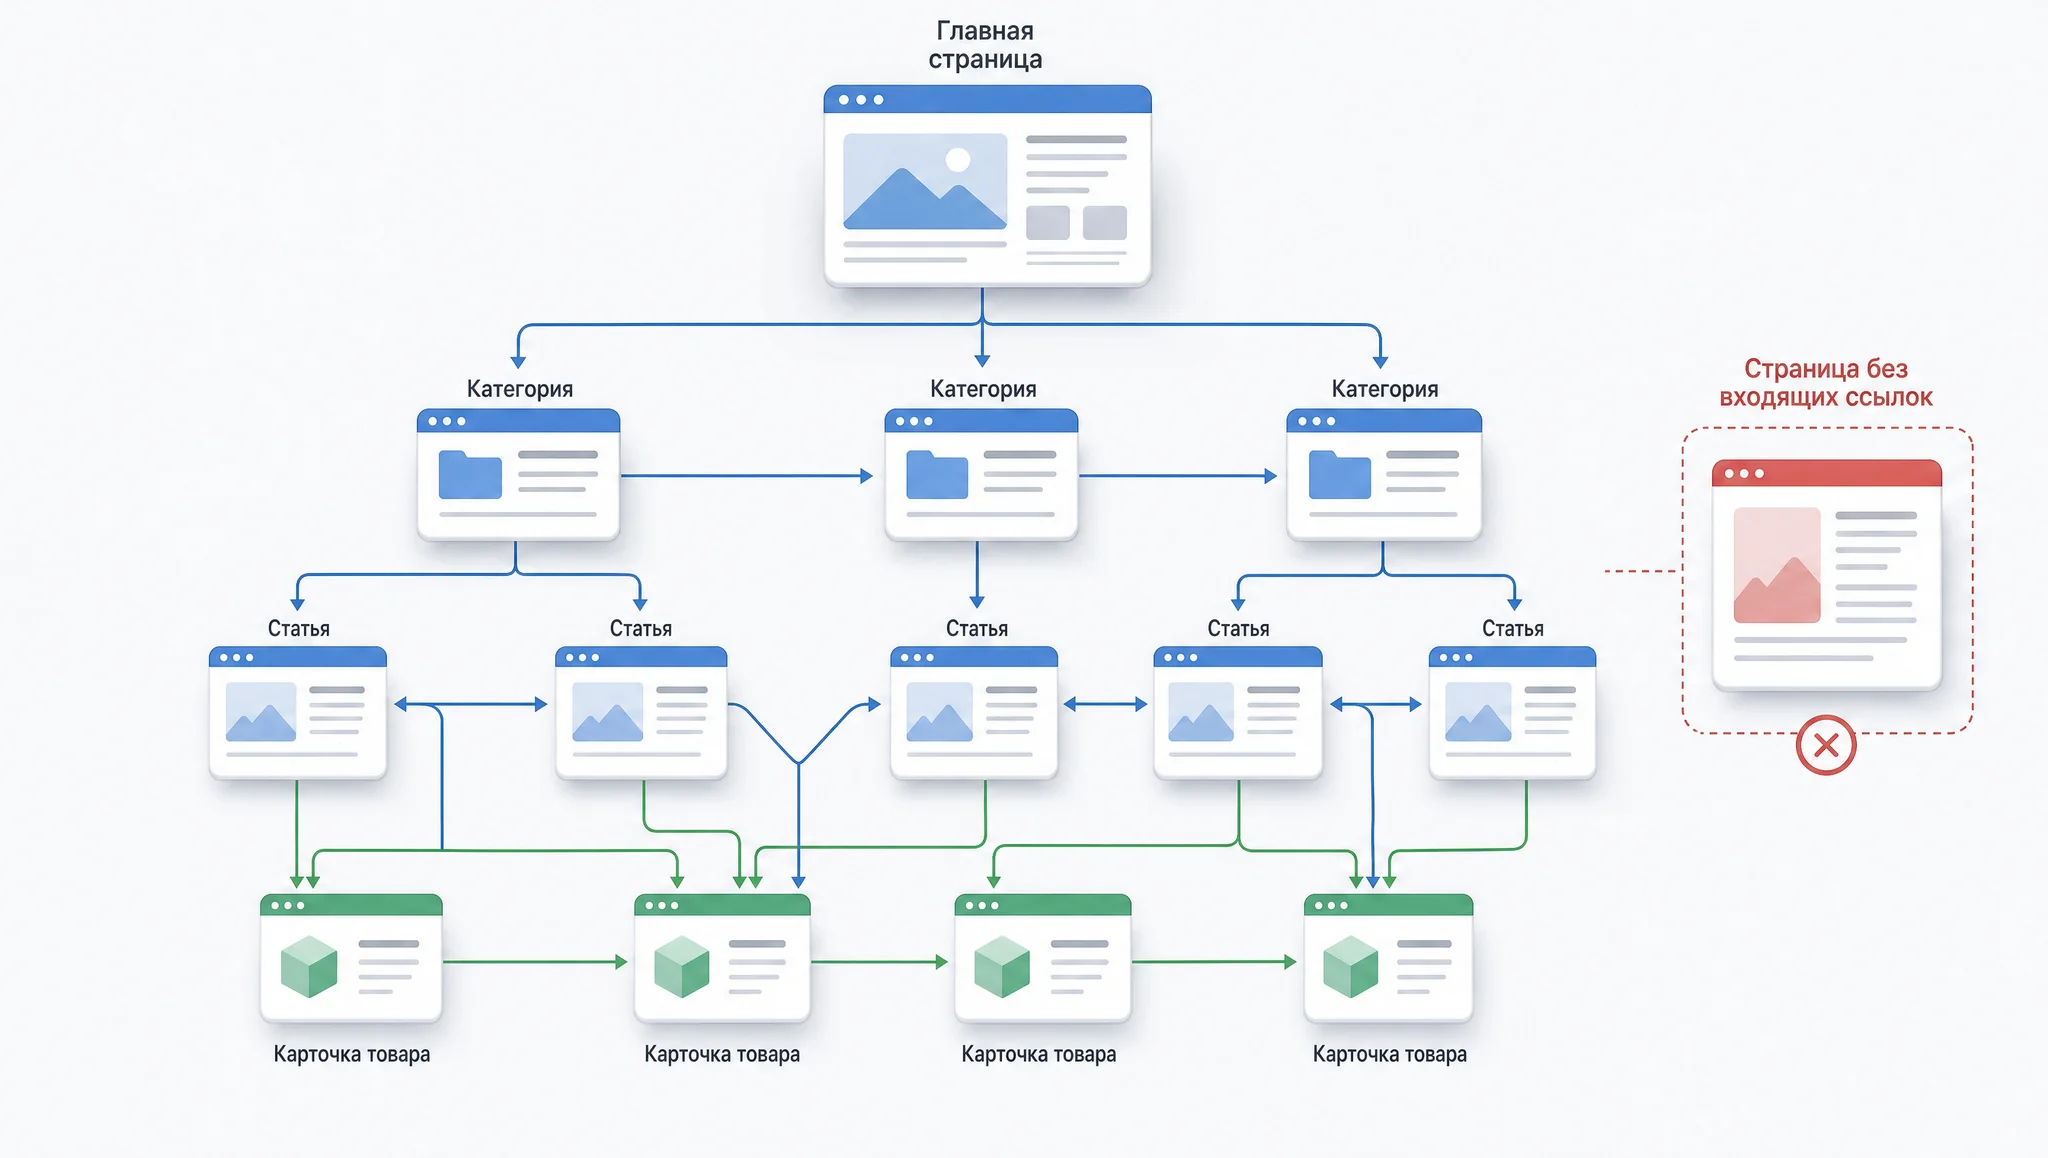
Самая быстрая проверка структуры: возьмите 10 страниц, которые должны приносить деньги или заявки, и попробуйте найти каждую с главной за несколько кликов. Если путь до страницы неочевиден человеку, проверьте навигацию и внутренние ссылки как отдельную проблему.
Находки превращаются в план работ
Приоритизированный план работ собирает находки аудита в задачи. Для каждой задачи укажите проблему, затронутые URL, доказательство, ожидаемый эффект и способ повторной проверки.
Слабый итог звучит так: «поправить SEO», «улучшить метатеги», «ускорить сайт», «разобраться с индексом». С такой задачей разработчик, редактор или владелец сайта не понимает, что именно делать и как проверить результат. Хорошая формулировка жестче: «на шаблоне карточек товара 5xx у 86 URL из выборки, пример - такие-то адреса; проверить код ответа после исправления и переобход в Вебмастере». Даже если вы делаете аудит для себя, такая точность экономит неделю блуждания.
Задача после аудита должна содержать:
- что сломано или не совпадает с целью страницы;
- какие URL, шаблоны или сегменты затронуты;
- где это видно: инструмент, отчет, метрика, пример;
- почему это влияет на индексацию, показы, клики или заявки;
- кто должен исправить: разработчик, редактор, SEO-специалист, владелец сайта;
- как и когда проверять результат после внедрения.
PR-CY заявляет проверку сайта более чем по 70 параметрам и общий чек-лист из 80 задач, которые можно отмечать в интерфейсе. Это хороший пример роли онлайн-сервиса: он помогает быстро собрать первичный список, особенно если нужно бесплатный SEO-анализ сайта онлайн с рекомендациями. Но финальный приоритет все равно ставит человек. Сервис не знает, что одна страница отвечает за половину заявок, а другая висит в подвале ради галочки.
Приоритет: влияние, доказанность и трудоемкость
Удобная оценка держится на трех вопросах. Первое: сколько важных страниц затронуто? Второе: есть ли доказательство в данных, а не только предположение? Третье: насколько сложно исправить? Массовая ошибка индексации на страницах услуг идет выше, чем переписывание ALT у декоративных картинок. Быстрая правка robots.txt с понятным эффектом идет выше, чем большой редизайн без ясного влияния на поиск.
Разложите задачи по четырем корзинам:
- срочно - блокеры обхода, индексации, серверные ошибки, массовые поломки шаблона;
- важно - страницы с показами, но слабым CTR, дублями, плохим соответствием запросу;
- планово - улучшение структуры, внутренних ссылок, сниппетов и контента без аварии;
- в запас - косметические предупреждения, которые не затрагивают ценные URL.
Повторная проверка тоже зависит от типа изменения. Серверные статусы и robots.txt можно перепроверить сразу. Переобход и индексация занимают дни или недели. Эффект на трафик и конверсии оценивают только после накопления показов и визитов. В Яндекс.Вебмастере после исправления ошибки можно нажать «Я всё исправил» и дождаться перепроверки роботом; если нарушение обнаружено повторно, повторно сообщить об устранении можно только через 30 дней.
После исправления ошибки в Яндекс.Вебмастере можно нажать «Я всё исправил» и дождаться перепроверки роботом; если нарушение обнаружено повторно, повторно сообщить об устранении можно только через 30 дней.
Контроль после исправлений
Для контроля трафика используйте Яндекс.Метрику и Google Analytics. В Яндекс.Метрике отчет «Источники, сводка» показывает, откуда посетители приходят на сайт, включая поисковые переходы. В Google Analytics 4 (GA4) отчет Traffic acquisition показывает, из каких источников пришли посетители: поиск, реклама, прямые заходы или другие каналы. Эти отчеты не заменяют проверку индексации, но показывают, стало ли больше органических визитов после исправлений.
Повторную диагностику ведите по срокам:
- Сразу после правки проверьте код ответа, robots.txt, редиректы и доступность страницы.
- Через несколько дней посмотрите переобход в Google Search Console и Яндекс.Вебмастере.
- Через 2-4 недели сравните показы, клики, CTR и среднюю позицию по важным URL.
- После накопления визитов оцените поисковый трафик и конверсии в аналитике.
- Если эффекта нет, вернитесь к причине: возможно, проблема была не главной.
Что не входит в самостоятельный аудит
Самостоятельная проверка хорошо ловит явные проблемы: закрытую индексацию, ошибки сервера, слабые Title, дубли и страницы без внутренних ссылок. Но она не заменяет профессиональный аудит, когда нужен PDF-отчет для команды, глубокий ссылочный анализ, проверка конкурентов, стратегия продвижения и контроль внедрения. В таком отчете фиксируют проверенные URL, найденные проблемы, ответственного за исправление, доказательство результата и срок возврата к проверке.
- URL или сегмент страниц, где найдена проблема;
- причина, которую нужно проверить или исправить;
- приоритет задачи для трафика, заявок или продаж;
- владелец задачи: разработчик, редактор, SEO-специалист или владелец сайта;
- срок повторной проверки и метрика, по которой видно изменение.
Финальный чек-лист SEO-аудита можно вести в обычной таблице. Сложный инструмент не обязателен. Главное, чтобы рядом с каждой задачей были URL, причина, приоритет, владелец и срок повторной проверки. Тогда аудит продвижения сайта перестает быть документом «на потом» и становится рабочей очередью.
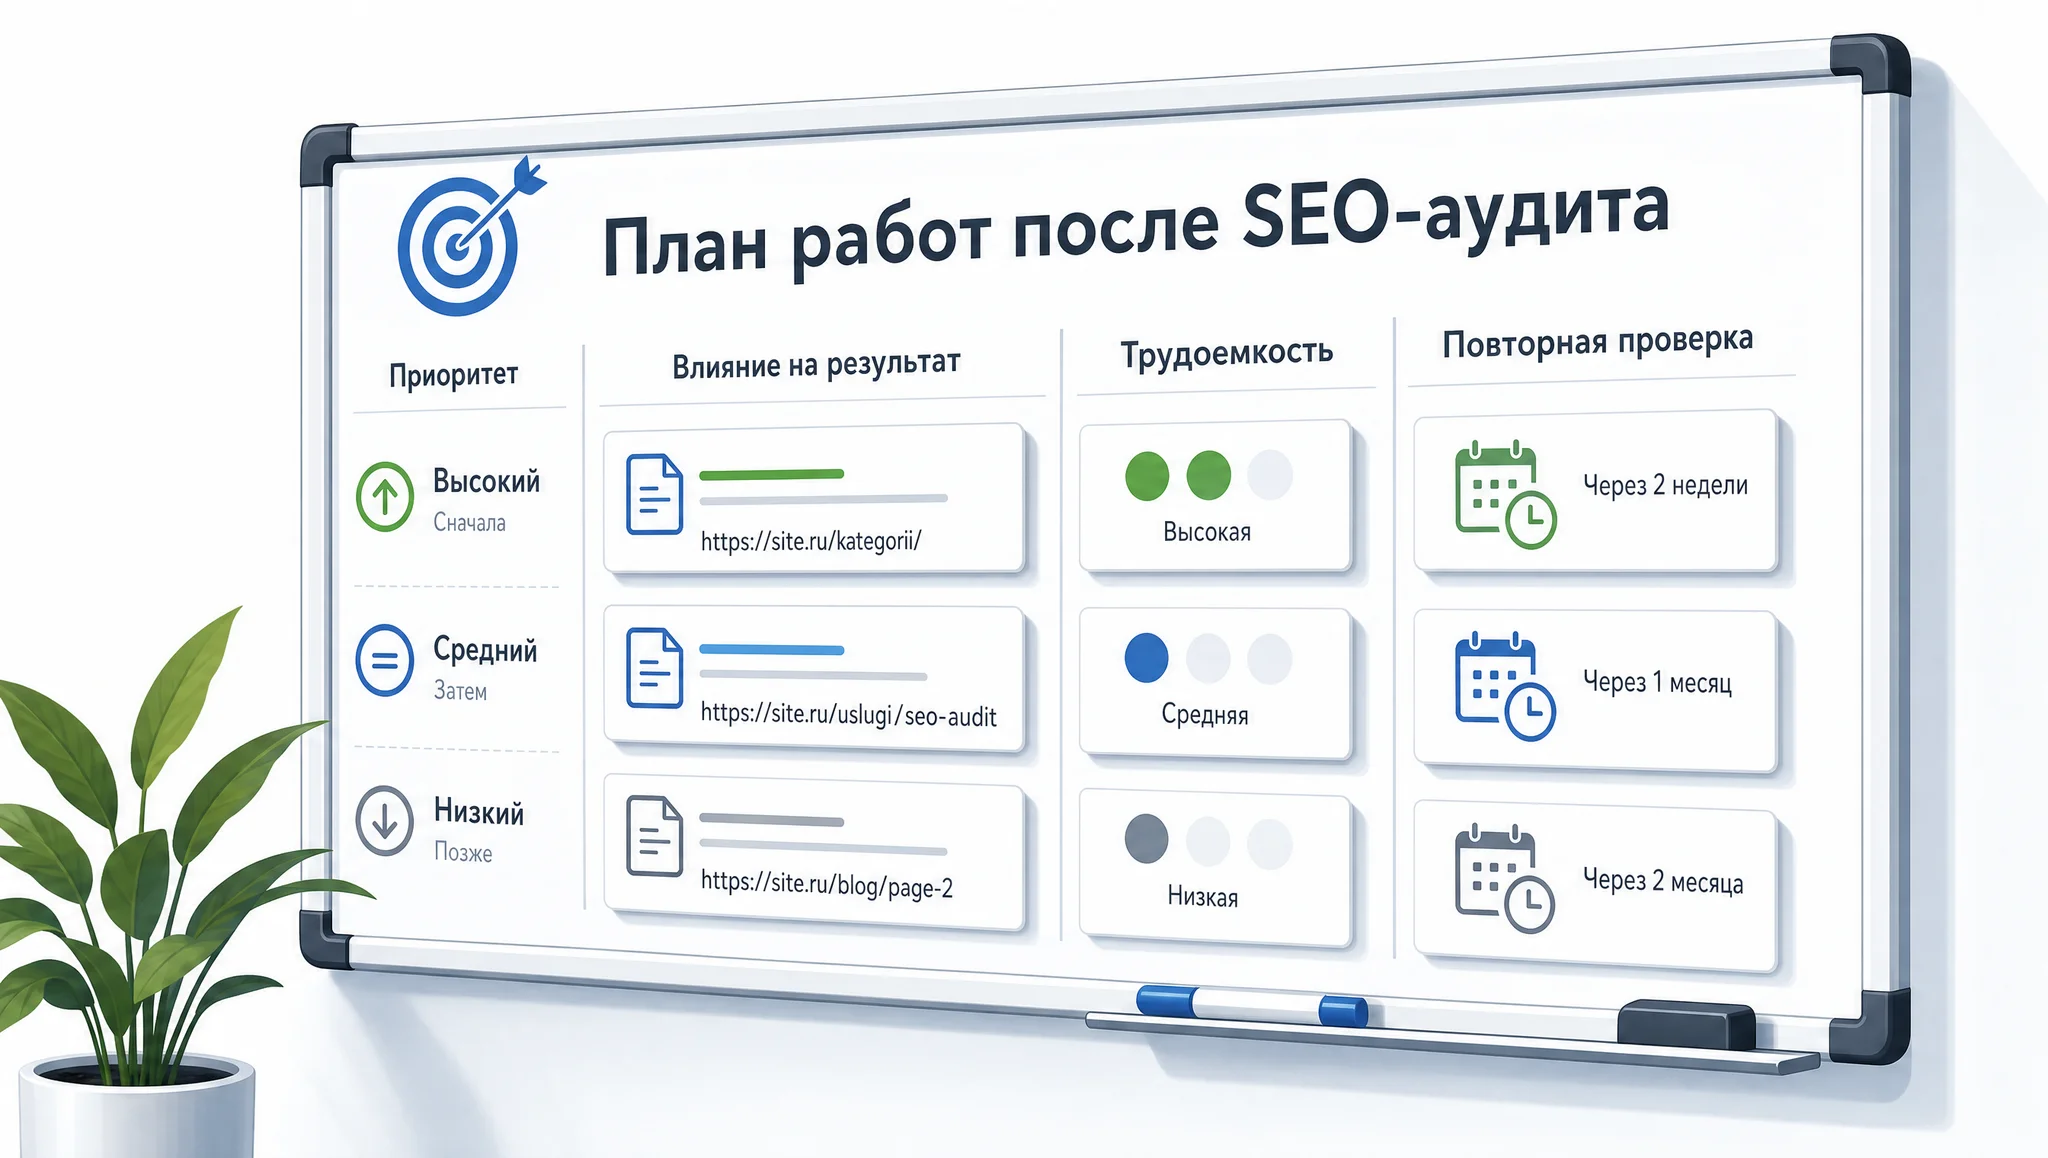
Начните с малого: выберите 20 страниц, которые важны для вашего трафика или заявок, и пройдите их по слоям - индексация, техника, контент, структура, план исправлений. Не гонитесь за идеальным отчетом. Сначала уберите то, что мешает поисковику найти и понять ваши ценные URL; потом улучшайте страницы, которые уже получают показы; и только после этого занимайтесь косметикой, иначе аудит снова превратится в красивый список без движения.
 155 просмотров
 Обсудить
 26 минут на чтение
 18.09.2026, 14:40



 Сайтов
 Страниц
 Видео

.5242c455a0303b436d68.svg)
.d6289f37f1093c657798.svg)

.bf739e4e9fd1c7bfdfa4.png)